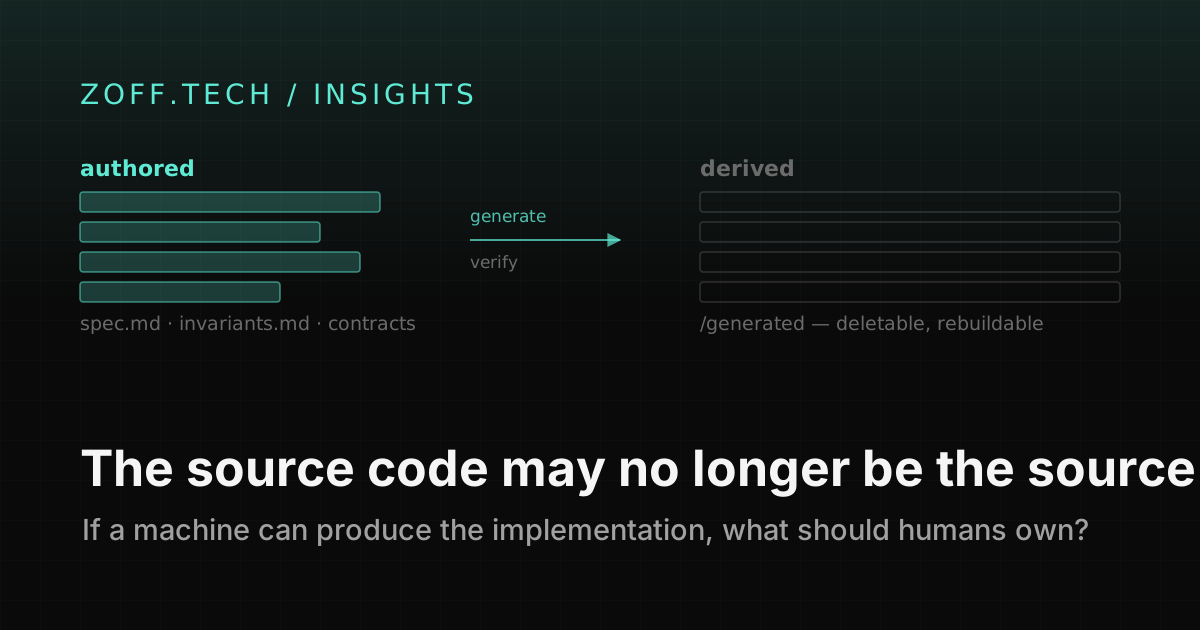
Hay una práctica que se está extendiendo por los repositorios y que parece mera limpieza. Los equipos ponen Markdown junto al código que gobierna: un AGENTS.md en la raíz, un documento de módulo al lado de cada paquete, las convenciones y los invariantes que un agente carga antes de escribir una línea. Nosotros mismos defendimos esa idea: un wiki dentro del repo, escrito para la máquina y no para quien acaba de entrar.
Esa idea ya ganó. Este ensayo empuja el paso siguiente, que no ha ganado y que puede resultar equivocado:
El Markdown quizá no solo viva junto al código fuente. Quizá se convierta en el artefacto del que se deriva el código fuente.
La pregunta interesante en ingeniería asistida por IA ya no es «¿escribirá el modelo el código?». Lo escribe. La pregunta de debajo es más difícil y se discute mucho menos:
Si una máquina produce una implementación de forma fiable, ¿cuál es el artefacto duradero que deberían poseer las personas?
La afirmación es acotada, y no es que el código deje de importar. El código sigue siendo la verdad ejecutable en runtime. La afirmación es más rara: el código puede dejar de ser el artefacto que las personas escriben principalmente sin dejar de ser el artefacto que las máquinas ejecutan.
Hoy:       requisitos -> interpretación humana -> código -> comportamiento
Posible:   especificación -> síntesis por agente -> código -> verificación -> comportamiento
El código siempre fue una abstracción
Cada generación de esta profesión le ha entregado una capa a la máquina.
código máquina -> ensamblador -> lenguajes de alto nivel -> frameworks
-> infraestructura declarativa -> lenguajes de dominio -> ?
Ya nadie escribe a mano la asignación de registros. Ya nadie entra por ssh a una máquina para editar un archivo de configuración y llama a eso desplegar. Cada peldaño se abandonó por las mismas dos razones, y en este orden: la traducción hacia abajo se volvió fiable, y el resultado se volvió verificable sin leerlo.
Ese orden importa, y es donde la analogía con la IA hay que tratarla con cuidado. Seguimos leyendo la salida del compilador cuando hace falta: dedicamos un post entero a leer ensamblador del JIT para averiguar por qué sobrevivía una comprobación de límites. La capa de abajo nunca se vuelve ilegible. Se vuelve algo que inspeccionas a propósito en lugar de escribir por defecto.
Una progresión histórica es una analogía, no una demostración. No establece que venga otro peldaño. Solo dice qué requiere un peldaño.
La IA cambia la economía de la traducción
Las especificaciones han fracasado muchas veces —requisitos en cascada, UML, arquitectura dirigida por modelos— y fracasaron por una razón estructural. Una persona seguía teniendo que convertir la especificación en implementación a mano. Eso convertía la spec en costo puro sin palanca: se escribía una vez, divergía en la tercera semana y era decoración para el sexto mes. El paso caro siempre fue este:
intención -> implementación
Los agentes de código han hundido el costo de ese paso en algo así como un orden de magnitud. Ese es todo el acontecimiento. Cuando la traducción es cara, guardas el conocimiento en la capa de más abajo, la que se ejecuta. Cuando la traducción se abarata, el sitio óptimo para guardar el conocimiento sube.
Pero barato no es lo mismo que fiable. La economía se movió; la confianza no se movió con ella. Todo lo difícil del desarrollo intent-first —la intención como fuente— vive en ese hueco.
Qué existe ya y qué sigue siendo una hipótesis
Esta distinción merece ser explícita, porque el espacio está muy ruidoso ahora mismo.
Ya en producción. Spec Kit, de GitHub, implementa un flujo Specify → Plan → Tasks → Implement → Converge en el que cada fase produce un artefacto Markdown que alimenta al siguiente. Kiro, de AWS, hace de la spec la unidad de trabajo: un documento de requisitos, un documento de diseño y una lista de tareas con trazabilidad hasta los requisitos. Los archivos de instrucciones para agentes son omnipresentes, y el modo planificar-luego-ejecutar —en lugar de un solo prompt, la instrucción suelta que se le lanza al modelo— es estándar en cualquier agente de código serio.
Apuestas comerciales en curso. Tessl es la versión más agresiva de la tesis: la spec como fuente y el código como una salida que se vuelve a generar y que no deberías editar a mano. En OpenAI, Sean Grove argumentó en The New Code que la unidad duradera de la programación son las especificaciones y no los prompts ni el código, y que el código que escribe una persona de ingeniería es una minoría del valor que aporta.
Todavía hipótesis, la mía incluida. Que una especificación más una suite de verificación carguen información suficiente para regenerar un servicio de producción no trivial, de forma repetida, entre versiones de modelo y quizá entre lenguajes. Nadie lo ha demostrado a escala. Lo que sigue explora qué tendría que ser cierto, no informa de lo que ya es.
Una especificación no es documentación
Casi todos los equipos ya tienen documentos que describen su sistema, y no es de eso de lo que va este ensayo. La diferencia es mecánica, no de estilo.
La documentación describe: así funciona el sistema. Una especificación restringe: así tiene que funcionar el sistema. Y la prueba para saber cuál tienes es brutalmente simple: una especificación puede tumbar un build, la ejecución que compila, verifica y empaqueta el sistema.
Especificación:   todo comando de pago debe ser idempotente.
Código generado:  no se honra ninguna idempotency key.
Resultado:        la verificación falla. El cambio no entra.
Un artefacto fuente de primera clase está versionado, se compara cambio a cambio, se revisa en pull requests, es autoritativo, lo leen tanto personas como máquinas, se usa para producir o validar la implementación y —la propiedad que sostiene todo— puede romper el build cuando la implementación no está de acuerdo con él.
La documentación deriva porque no pasa nada cuando está equivocada. Esa es toda la diferencia, y no es un detalle de tooling. Es la diferencia entre un artefacto y un comentario.
Por qué Markdown, y dónde se rompe
Markdown es un buen candidato a contenedor, por razones nada glamurosas: las personas lo leen, los modelos lo parsean, Git compara los cambios con granularidad de frase —así la revisión se vuelve semántica—, es independiente de la herramienta, ya es donde miran los agentes y embebe otros formatos sin quejarse.
También es genuinamente malo como lenguaje de especificación. No tiene semántica formal, ni sistema de tipos, ni validación, y la prosa es más vaga justo donde la ingeniería es más descuidada: «un timeout razonable» —¿cuántos milisegundos de espera máxima?—, «gestionar los errores con elegancia» —¿cuáles?—, «debería ser rápido». Esas frases sobreviven a la revisión porque quien lee las rellena en silencio. El agente también las rellena, solo que distinto y sin avisar.
Así que la capa de intención realista es Markdown como contenedor de cosas que no son Markdown:
prosa               razón de ser, semántica del dominio, por qué existe la restricción
front matter        atributos y umbrales legibles por máquina
esquemas            OpenAPI, JSON Schema, SQL DDL, Protobuf
ejemplos            escenarios Gherkin, casos dorados, casos límite
propiedades         invariantes enunciados para que un test los imponga
política            reglas de arquitectura, permisos, tratamiento de datos
Markdown es el contenedor. No es la semántica. La tesis es la intención como fuente, no el maximalismo Markdown.
Cómo se ve un repositorio con la especificación primero
/intent
  /payments
    overview.md          propósito, lenguaje del dominio, límites
    requirements.md      comportamiento que el servicio debe exhibir
    invariants.md        lo que siempre tiene que ser cierto
    api.md               interfaz y garantías de compatibilidad
    security.md          modelo de autorización, datos, notas de amenazas
    failure-modes.md     qué pasa cuando falla cada dependencia
  /identity
    authentication.md
    authorization.md
    threat-model.md

/contracts               la superficie comprobable por máquina
  payment-api.yaml
  events.json
  schema.sql

/policy                  restricciones sobre cómo se puede construir cualquier cosa
  architecture.md
  dependencies.md
  data-handling.md

/tests                   la mitad ejecutable de la especificación
  acceptance/  contracts/  properties/  security/

/decisions
  ADR-001-event-driven-payments.md
  ADR-002-idempotency-strategy.md

/generated
  /services  /clients  /migrations
Un directorio de ese árbol carga con todo el argumento: /generated. En la forma fuerte de este modelo deberías poder borrarlo y reconstruirlo. Si puedes o no, esa es la prueba de si tu capa de intención es real. Hoy, en la mayoría de los sistemas, no puedes, y el hueco entre lo que dice la spec y lo que hace el código es exactamente el conocimiento que ahora mismo solo existe en la cabeza de algunas personas.
Así empieza a verse una especificación lo bastante densa como para generar a partir de ella. Fíjate en lo poco que contendría de esto un README convencional.
# Transferir fondos

## Propósito
Mover dinero entre dos cuentas internas preservando la consistencia
del ledger y evitando transacciones duplicadas.

## Precondiciones
- Ambas cuentas existen y están activas.
- El importe es mayor que cero y coincide con la moneda de la cuenta.
- El origen tiene saldo disponible suficiente.

## Invariantes
1. El dinero nunca se crea ni se destruye.
2. Los asientos de débito y crédito siempre cuadran.
3. Una idempotency key nunca produce dos transferencias.
4. Una transferencia fallida no deja estado parcial en el ledger.

## Interfaz
POST /transfers
  body: sourceAccountId, destinationAccountId, amount, currency, idempotencyKey
  201 -> transferencia creada
  409 -> saldo insuficiente
  404 -> cuenta desconocida o inactiva
  200 -> idempotency key ya vista; devuelve el resultado original

## Comportamiento ante fallo
- Cualquier fallo interno antes del commit no muta nada.
- Las escrituras al ledger y la emisión de eventos comparten frontera transaccional.

## Rendimiento
p95 por debajo de 250 ms a 400 peticiones por segundo.

## Seguridad
- Quien llama necesita el permiso transfers:create.
- La titularidad de la cuenta se verifica en el servidor, nunca se confía en la petición.
- Los eventos emitidos no llevan números de cuenta ni datos personales.

## Observabilidad
Eventos: transfer.started, transfer.completed, transfer.failed
Métricas: latencia, tasa de fallo, tasa de saldo insuficiente
Ese documento es a la vez la entrada para la implementación, para generar los tests, para la revisión de código, para el runbook —el manual con el que se opera el servicio— y para cualquier regeneración futura. Un README no es nada de eso.
Tres capas, y la que lo decide todo
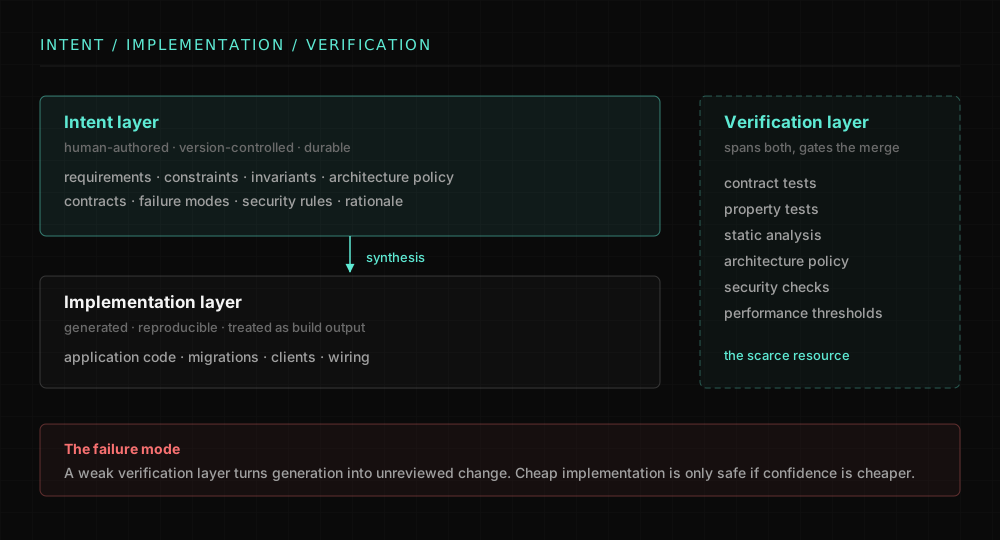
La capa de intención es de las personas y es duradera. La capa de implementación es generada y, en la forma fuerte, desechable. La capa de verificación no es un paso al final: abarca las dos, y es el único mecanismo que convierte generación probabilística en algo que estás dispuesto a desplegar.
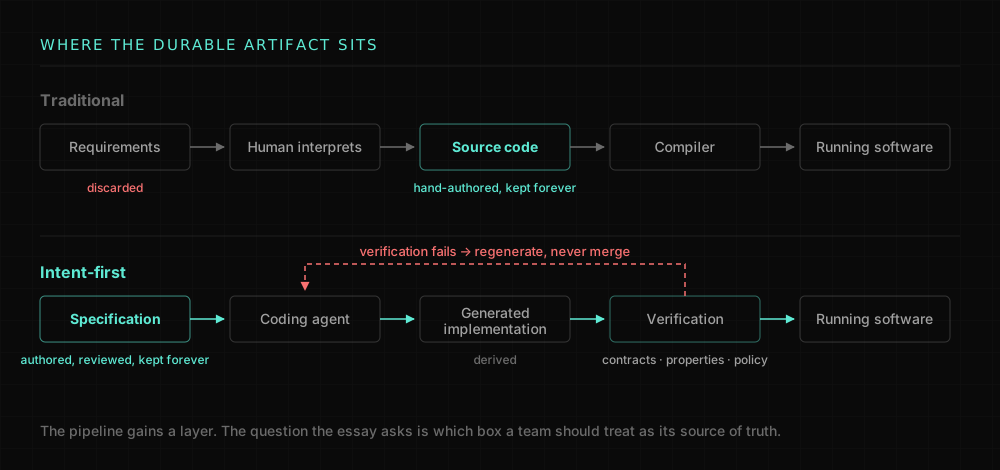
Ese pipeline —la cadena de pasos automáticos que va del cambio a producción— gana una capa entera. Y un LLM no es un compilador, así que la analogía se rompe exactamente aquí: ejecuta la misma especificación dos veces y obtienes dos implementaciones distintas. La reproducibilidad no puede venir de una salida idéntica. Tiene que venir de comportamiento equivalente y verificado, una garantía mucho más débil que la de un compilador, y que hay que ganarse con maquinaria:
- versiones de modelo y de agente fijadas, registradas y cambiadas de forma deliberada
- una lista de dependencias aprobadas, impuesta en CI y no en comentarios de revisión
- comprobaciones de política de arquitectura que tumban el build
- tests de contrato, tests de propiedades, escaneo de seguridad, umbrales de rendimiento
- metadatos de procedencia adjuntos a cada artefacto generado
generated_by:
  model: <versión de modelo fijada>
  agent_version: 3.4.1
  specification_commit: 7b234af
  policy_commit: c91e02d
  generated_at: 2026-09-21T15:00:00Z
Ese último bloque es un artefacto de cadena de suministro. En cuanto el código se produce a máquina y en volumen, «qué modelo generó esto, desde qué spec y bajo qué política» se convierte en una pregunta que alguna auditoría acabará haciendo, y en una pregunta que deberías querer responder antes de que la hagan.
La verificación pasa a ser el recurso escaso
Si la implementación es barata de producir, lo que de verdad te falta es confianza en ella. Los tests dejan de ser algo que valida el código y pasan a ser algo que define el comportamiento.
Para toda transferencia interna aceptada:
  suma(saldos antes) == suma(saldos después)
Esa propiedad probablemente sobreviva a cada línea de C# que hoy la satisface. Es el artefacto más valioso, y ocupa cuatro líneas.
Aquí vive también el modo de fallo más afilado. Una capa de verificación escrita por el mismo agente que escribió la implementación, a partir de la misma mala lectura de la misma frase ambigua, no demuestra nada: un modelo no puede corregir su propio examen. La puerta tiene que ser determinista y de origen independiente, que es la misma disciplina que poner un verificador dentro del loop del agente: la generación puede ser probabilística solo porque algo no probabilístico decide si el resultado sale.
Qué pasa con la revisión de código
Piensa en cómo se ve un pull request cuando lo que escriben las personas es la intención.
 ## Límites de transferencia
-Transferencia máxima: 10.000 USD
+Transferencia máxima: 25.000 USD

 ## Autorización
+Por encima de 10.000 USD hace falta el permiso transfers:approve-high-value.
Cinco líneas cambiadas. El diff generado por debajo —el conjunto de líneas que el cambio añade y quita— puede ser de mil cuatrocientas. Pero la unidad revisable, aquello en lo que una persona debería gastar criterio, es el cambio de comportamiento y su justificación, no la fontanería. Las preguntas se desplazan:
- ¿Qué comportamiento cambió y por qué?
- ¿Qué restricciones se movieron y a quién afecta ese movimiento?
- ¿Siguen completos los invariantes después de este cambio?
- ¿Demostró la verificación que la implementación los satisface?
Eso es mejor revisión que la que tiene la mayoría de los equipos hoy, donde alguien aprueba 1.438 líneas de diff ojeando las 40 interesantes. Y solo vale lo que valga la capa de verificación de debajo. Sin ella, esto no es revisión semántica: es ceremonia con un diff más corto.
La arquitectura deja de ser un documento
Los agentes son buenísimos produciendo sistemas localmente correctos y globalmente incoherentes. Cada archivo es razonable. El sistema es un pantano. Eso hace que la arquitectura sea más importante en un modelo intent-first, no menos, pero solo si la intención arquitectónica se expresa de forma que pueda rechazar un cambio.
Un servicio no puede leer la base de datos de otro servicio.
La comunicación entre servicios es asíncrona y transportada por eventos.
Todo comando acepta y honra una idempotency key.
Los cambios de API pública mantienen compatibilidad hacia atrás dos versiones.
No se añade ninguna dependencia sin una entrada aprobada.
Los datos personales nunca aparecen en los logs de aplicación.
Cada una de esas frases se puede comprobar de forma mecánica. La salida de quien hace arquitectura pasa de ser un diagrama que describe el sistema previsto a ser una política que un agente no puede violar sin tumbar CI: el mismo movimiento que dibujarle al agente un mapa de permisos explícito en vez de confiar en que se porte bien.
Las objeciones, en serio
«El lenguaje natural es ambiguo». Correcto, y es el instinto adecuado. La respuesta no es prosa sin restricciones, sino el contenedor por capas de más arriba: prosa para la razón de ser, y esquemas, tipos y ejemplos ejecutables para todo lo que tenga que ser exacto. Conviene notar además que la ambigüedad no es nueva. Hoy vive en la cabeza de alguien en lugar de en un archivo que cualquiera pueda revisar y comparar.
«El código es la única especificación precisa». Es la objeción más fuerte y en parte tiene razón. Pero el código es preciso sobre lo que un sistema hace, no sobre lo que debe hacer. No distingue un invariante de un accidente. Todo codebase contiene comportamiento que nadie quiso y comportamiento que nadie puede cambiar jamás, y en el fuente se ven idénticos. Esa distinción es justo lo que guarda la capa de intención.
«El código generado igual hay que depurarlo». Sí, y la ingeniería va a seguir leyendo implementación durante muchos años. La pregunta no es si las personas tocan código. Es si el código sigue siendo el principal artefacto escrito por personas.
«Los modelos alucinan». La restricción central, y la razón de que el modelo aquí sea especificación → generación → verificación determinista y nunca prompt → código → deploy. Si quitas el tercer paso, nada de esto funciona: solo has industrializado la producción de sistemas plausibles.
«Esto solo mueve la deuda de sitio». La objeción que me parece más persuasiva. Si la especificación es la fuente, una especificación desactualizada es un bug de producción y no un bug de documentación, y la deuda de especificación compone igual que la de código. Eso implica una disciplina —llámala ingeniería de especificaciones— en la que casi nadie, nosotros incluidos, es bueno todavía.
«Regenerar es caro». Cierto. Regenerar un sistema grande cuesta dinero real y tiempo real de reloj. La forma fuerte de este modelo es económicamente absurda hoy para la mayoría de los sistemas, y por eso el camino de adopción de más abajo se queda bastante corto de ella.
«Nuestro sistema no se puede describir así de limpio». A menudo cierto, y es un punto de parada legítimo. Un sistema legacy cuyo comportamiento nadie conoce del todo no se puede especificar hasta la existencia. Y los sistemas distribuidos exhiben comportamiento emergente que ninguna especificación por componente predice.
Un espectro, no un interruptor
| Nivel | Qué significa | Dónde están los equipos |
|---|---|---|
| 0 | Código primero, sin agentes | ya raro |
| 1 | Programación asistida, prompt a prompt | común |
| 2 | Agentes que implementan desde tickets o prompts sueltos | común |
| 3 | Especificaciones estructuradas dirigen la implementación, con la verificación como puerta | primeros adoptantes |
| 4 | Especificaciones y tests regeneran componentes enteros | experimental |
| 5 | La implementación se trata como salida de build reproducible | hipotético |
Casi todas las organizaciones con las que trabajamos están entre el nivel 1 y el 2. La pregunta de ingeniería interesante es qué requiere de verdad el nivel 3, porque el nivel 3 se paga solo aunque el 4 y el 5 no lleguen nunca. Una especificación lo bastante precisa para generar a partir de ella también lo es para hacer onboarding, para revisar contra ella y para depurar desde ella a las tres de la mañana.
Un experimento que vale una semana
Elige un servicio interno pequeño que ya tengas y entiendas. Escribe su capa de intención desde cero: visión general, requisitos, invariantes, interfaz, seguridad, modos de fallo, observabilidad. Escribe los contratos. Escribe los tests de aceptación y de propiedades. Después entrégale a un agente solo esos artefactos —no el código existente— y pídele que implemente el servicio.
Luego mide lo interesante:
- ¿Qué información faltaba y tuviste que aportar a mano?
- ¿Qué dio por sentado el agente, y eran razonables esas suposiciones?
- ¿Qué requisitos resultaron ambiguos solo cuando otra cosa los leyó?
- ¿Qué tests cazaron una suposición equivocada, y cuáles se colaron?
- ¿Podría un segundo modelo producir una implementación compatible con los mismos artefactos?
- ¿Cuánto del resultado tuviste que modificar a mano, y por qué?
El experimento es valioso cuando falla, que es lo más probable. La lista de cosas que el agente hizo mal es un inventario exacto de lo que omite tu documentación actual, y es la misma lista que descubre en el tercer mes quien acaba de entrar, y la misma que encuentra un incidente a las tres de la mañana.
¿Cuál es el activo, en realidad?
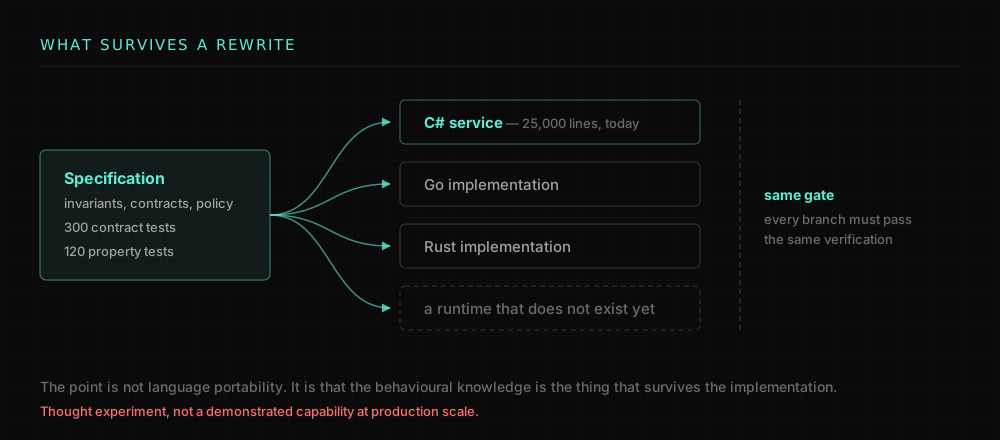
Supón un servicio de 25.000 líneas de C#, y supón que su comportamiento está genuinamente capturado por ochenta páginas de especificación, trescientos tests de contrato, ciento veinte tests de propiedades, sus esquemas y sus políticas. Si un agente produce una implementación en Go que pase todo eso, ¿cuál de las dos era el activo intelectual?
No creo que esa pregunta esté resuelta. Pero fíjate en que ahora se puede formular, y hace diez años no. El mismo replanteamiento aplica a dónde debería invertir una organización: el conocimiento del dominio, los sistemas de evaluación, la historia operativa y la política de arquitectura son todos más difíciles de reproducir que el código de aplicación, y son la parte de la que casi todos los equipos llevan el peor registro.
También convierte «código fuente» en una expresión algo extraña. Si el código se genera, la fuente está en otro sitio, y todavía no tenemos buenas palabras para las capas:
fuente de intención -> fuente de implementación -> artefacto ejecutable
Dónde nos deja esto
Nada de esto es inevitable, y quiero tener cuidado de no escribir como si lo fuera. Los modelos pueden estancarse. Regenerar puede seguir siendo demasiado caro. La deuda de especificación puede resultar peor que la de código. La posición honesta es que el desarrollo intent-first es hoy una dirección plausible con algo de tooling en producción, mucho entusiasmo comercial y casi ninguna evidencia a escala.
Pero merece la pena actuar en su forma débil ya, porque la forma débil es simplemente buena ingeniería. Escribe los invariantes. Haz que las restricciones se puedan comprobar por máquina. Trata la especificación como algo capaz de tumbar un build. Eso compensa llegue o no la forma fuerte.
El artefacto más duradero del software quizá acabe no siendo ni el código ni el binario, sino la representación estructurada de la intención humana a partir de la cual se pueden recrear los dos.
Algunas preguntas con las que quedarse:
- ¿Qué porcentaje de tu codebase es conocimiento genuinamente irreducible, y cuánto existe solo porque hoy una persona tiene que deletrearlo todo?
- ¿Qué información haría falta para regenerar desde cero tu servicio más importante?
- ¿Son tus tests lo bastante fuertes para distinguir una implementación correcta de una meramente plausible?
- Si desaparecieran las especificaciones pero sobreviviera el código, ¿seguirías entendiendo por qué existe el sistema?
Y con la que yo empezaría:
Si un agente pudiera regenerar todo tu codebase mañana, ¿qué desearías haber preservado hoy?