Pregúntale a un equipo directivo qué hizo ayer su agente y la respuesta honesta suele ser un conteo. Corrió 1.400 veces. Nadie sabe decir cuántas de esas funcionaron, qué costaron, ni por qué la ejecución 4812 le envió a un cliente un reembolso dos veces. Este ensayo trata de la observabilidad de la que depende la etapa Escalar de Descubrir, diseñar, construir, escalar, escrito para la gente que aprueba el presupuesto y no para la que conecta la trazabilidad.
La observabilidad no es un tablero
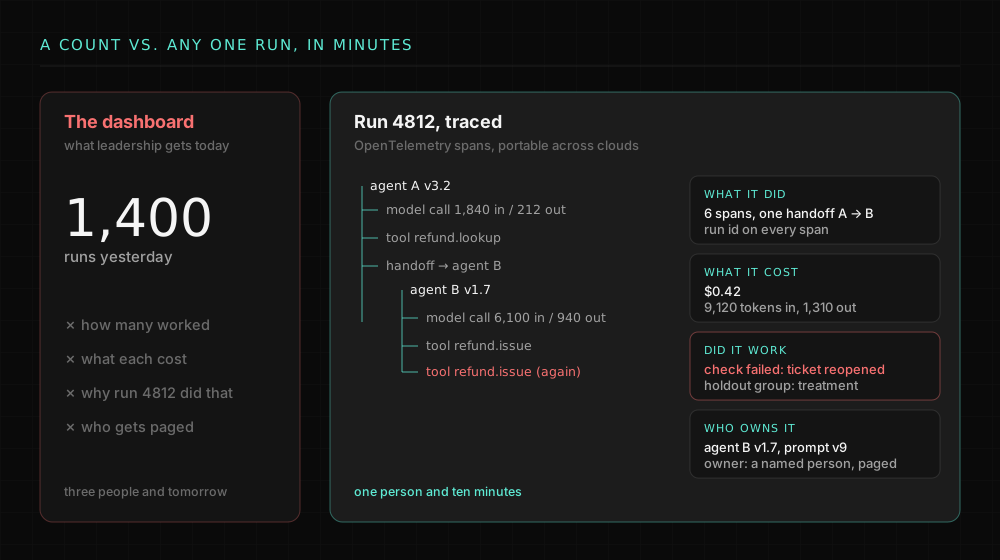
Un tablero muestra totales. La observabilidad es la capacidad de tomar cualquier ejecución individual y responder, en minutos, cuatro preguntas: qué hizo, qué costó, funcionó, y quién responde. Si alguna de las cuatro necesita que un ingeniero rebusque en los logs durante una tarde, el agente no es observable, por bueno que se vea el tablero.
La razón por la que esto importa en Escalar y no antes: con un agente y un equipo pequeño, la gente tiene el sistema en la cabeza. En Escalar la gente cambia, los modelos cambian, y el segundo agente empieza a llamar al primero. No puedes depurar lo que no puedes trazar, y no puedes escalar lo que no puedes depurar.
Las cuatro cosas, por ejecución
Qué hizo. Una traza: el árbol de pasos que dio el agente, cada llamada al modelo y a cada herramienta como un nodo, con sus entradas y salidas adjuntas. No un registro de eventos, que te dice que algo pasó, sino un árbol, que te dice por qué. Cuando el agente A le pasa el trabajo al agente B, la traza cruza esa frontera sin perder el hilo. En la práctica, esto significa que cada span lleva un identificador de ejecución, una estampa de versión del agente y del prompt que lo produjo, y la identidad bajo la que actuó.
Qué costó. Tokens de entrada y de salida, por llamada al modelo, sumados en un costo por ejecución, en moneda. No una factura mensual dividida por un conteo de ejecuciones, que esconde el único flujo que cuesta diez veces más que los demás. El costo en la traza es lo que le permite a un dueño notar que un prompt creció o que apareció un ciclo de reintentos, la misma semana en que ocurrió.
Si funcionó. El veredicto de una comprobación que no es el modelo: las pruebas pasaron, el ticket se cerró sin reabrirse, una persona aprobó. Registrado en la ejecución, para que la tasa de aciertos sea una consulta y no una encuesta. Es la misma comprobación que controla el eval y juzga el grupo de control. Si la ejecución estaba en el grupo de control, eso también se registra, para que el beneficio pueda calcularse a partir de las propias trazas.
Quién responde. El agente, su versión y el dueño con nombre, en cada ejecución. Cuando algo sale mal a las 3 de la mañana, la alerta le llega a una persona, y esa persona puede ver la traza que la causó. El runbook de las 3 de la mañana da por hecho que esto existe.
Por qué insisto en un formato portable
Cada nube te va a vender observabilidad para los agentes construidos sobre su plataforma. Azure la tiene para los agentes en Foundry; Google la tiene para los agentes en Vertex. Las dos son buenas. Las dos son también un impuesto de dependencia si son el único lugar donde pueden vivir tus trazas, porque en el momento en que tengas un agente en la otra nube, o una herramienta que no corre en ninguna, tendrás dos medias fotos.
Por eso instrumento una sola vez, con las convenciones de OpenTelemetry para IA generativa, y envío las trazas a donde el cliente ya mira. Las guías de campo para Azure AI Foundry y para Vertex AI muestran cómo hacerlo sin renunciar a las herramientas nativas. El propio framework de Google enumera la trazabilidad distribuida, el registro estructurado y roles asignados para el monitoreo como el núcleo de lo que llama AgentOps. Estoy de acuerdo con la lista y le agrego el requisito de portabilidad.
Qué le permite hacer esto a un directivo que un tablero nunca le permitirá
- Responder la pregunta del incidente. "Por qué hizo eso" se convierte en un enlace a una traza, no en una reunión.
- Ver el costo por flujo de trabajo, no por mes. El flujo caro se arregla o se retira; los baratos reciben más volumen.
- Confiar en el número del beneficio. El veredicto del grupo de control se calcula a partir de las mismas trazas que muestran las ejecuciones, así que nadie tiene que creerle al proveedor.
- Detectar la degradación sin despliegue detrás. Una actualización del modelo o un documento que cambió aparece como una caída en la tasa de aciertos sobre el flujo de trazas antes de que un cliente lo note.
- Aprobar el segundo agente con evidencia. Las trazas del primer agente son el caso de negocio del siguiente.
Una prueba de cinco minutos para el agente que ya tienes
Elige al azar una ejecución de la semana pasada. Pídele a tu equipo que te diga, dentro de la hora, qué hizo paso a paso, qué costó en moneda, si pasó la comprobación propia del cliente, y a quién le habría llegado la alerta si hubiera fallado. Mide cuánto tarda y cuánta gente involucra. Si la respuesta es una persona y diez minutos, tienes observabilidad. Si son tres personas y mañana, tienes un tablero.
Correr esa prueba, y mapear la distancia entre lo que tienes y las cuatro preguntas, es una de las primeras cosas que hago en una evaluación de preparación para IA sin costo. Es también el camino más corto que conozco de "tenemos un agente" a "operamos agentes".